

 43680
 45

过去几年,推理消耗的Token爆炸式增长,Token经济随之成型,推理专用芯片也持续升温:去年年底,英伟达以约200亿美元对AI芯片初创公司Groq进行“收购”(acqui-hire);做晶圆级“大芯片”的Cerebras今年6月IPO,市值达到670亿美元;OpenAI联手博通,推出了首款自研推理芯片Jalapeño,从设计到流片仅用了9个月——加上我们之前聊过的谷歌TPU,推理芯片牌桌上的玩家越来越多。
在这场推理芯片大战中,各家真正比拼的是什么?为什么走向了不同的技术路径?推理芯片未来又会向什么方向收敛?
本期硅谷101,我们请来两位AI芯片创业者,逐一拆解这些热门推理芯片在技术路径上的取舍与得失。其中嘉宾Mark是英伟达首席科学家Bill Dally的学生。Bill Dally是现代GPU并行架构最重要的奠基者之一。我们也借由Mark的视角,去了解这位芯片大师是如何思考问题和看待创新的。
【主播】
泓君,硅谷101创始人,播客主理人
【嘉宾】
Mark,AI芯片创业者
徐子扬,AI芯片创业者
【你将听到】
Groq、Cerebras技术路线
04:17 为什么训练看算力,推理看带宽
14:13 SRAM、DRAM、HBM的优劣
16:39 Groq和Cerebras的技术路径选择
19:34 Groq:确定性、静态编译调度,动态性不足
25:18 Cerebras 的软肋:良率、成本与系统适配
32:32 英伟达为什么要acqui-hire Groq
33:58 “推理时代,Cuda一定会被绕过”
推理时代芯片护城河
39:19 两位芯片创业者的SRAM推理芯片方案
41:07 最重要的指标:速度、性价比、耗电量
44:25 速度越快,AI越聪明
49:04 面对模型迭代,抓住“不变量”
54:15 消失的算力:为何芯片利用率跑不满
58:27 芯片设计全流程:需求、架构、RTL、验证、后端、流片、封装测试、良率、交付
01:01:16 国内优势:供应链+基础设施+开源生态
01:03:17 创业者做芯片,如何和模型厂商竞争
Bill Dally芯片设计哲学
01:05:17 为未来AI补齐强逻辑
01:09:40 “一切围绕局部性展开”
01:11:43 跳出local minimum,必须想清楚牺牲什么
01:13:03 Bill给学生的创业建议
01:14:47 亚马逊的工程哲学
OpenAI自研推理芯片解析
01:17:30 Jalapeño:通用芯片,低能耗,9个月流片
01:20:10 选择HBM4,不缺钱,但缺电
01:24:15 SRAM优势还能保持多久
01:27:03 芯片内异构,暗硅,另一种路径
【硅谷101年会来了,线下见】
10月10日—11日,我们将在【硅谷】举办Alignment 2026年度大会,从大模型、Agent、机器人到AI Infra,从实验室里的突破,到真实世界的商业化,我们直击AI变化最剧烈的前沿。 来自OpenAI、Anthropic、NVIDIA、Meta、Google DeepMind、SemiAnalysis、Cerebras等公司的研究者、创业者与投资人将齐聚现场,分享正在发生的机遇和挑战。
报名链接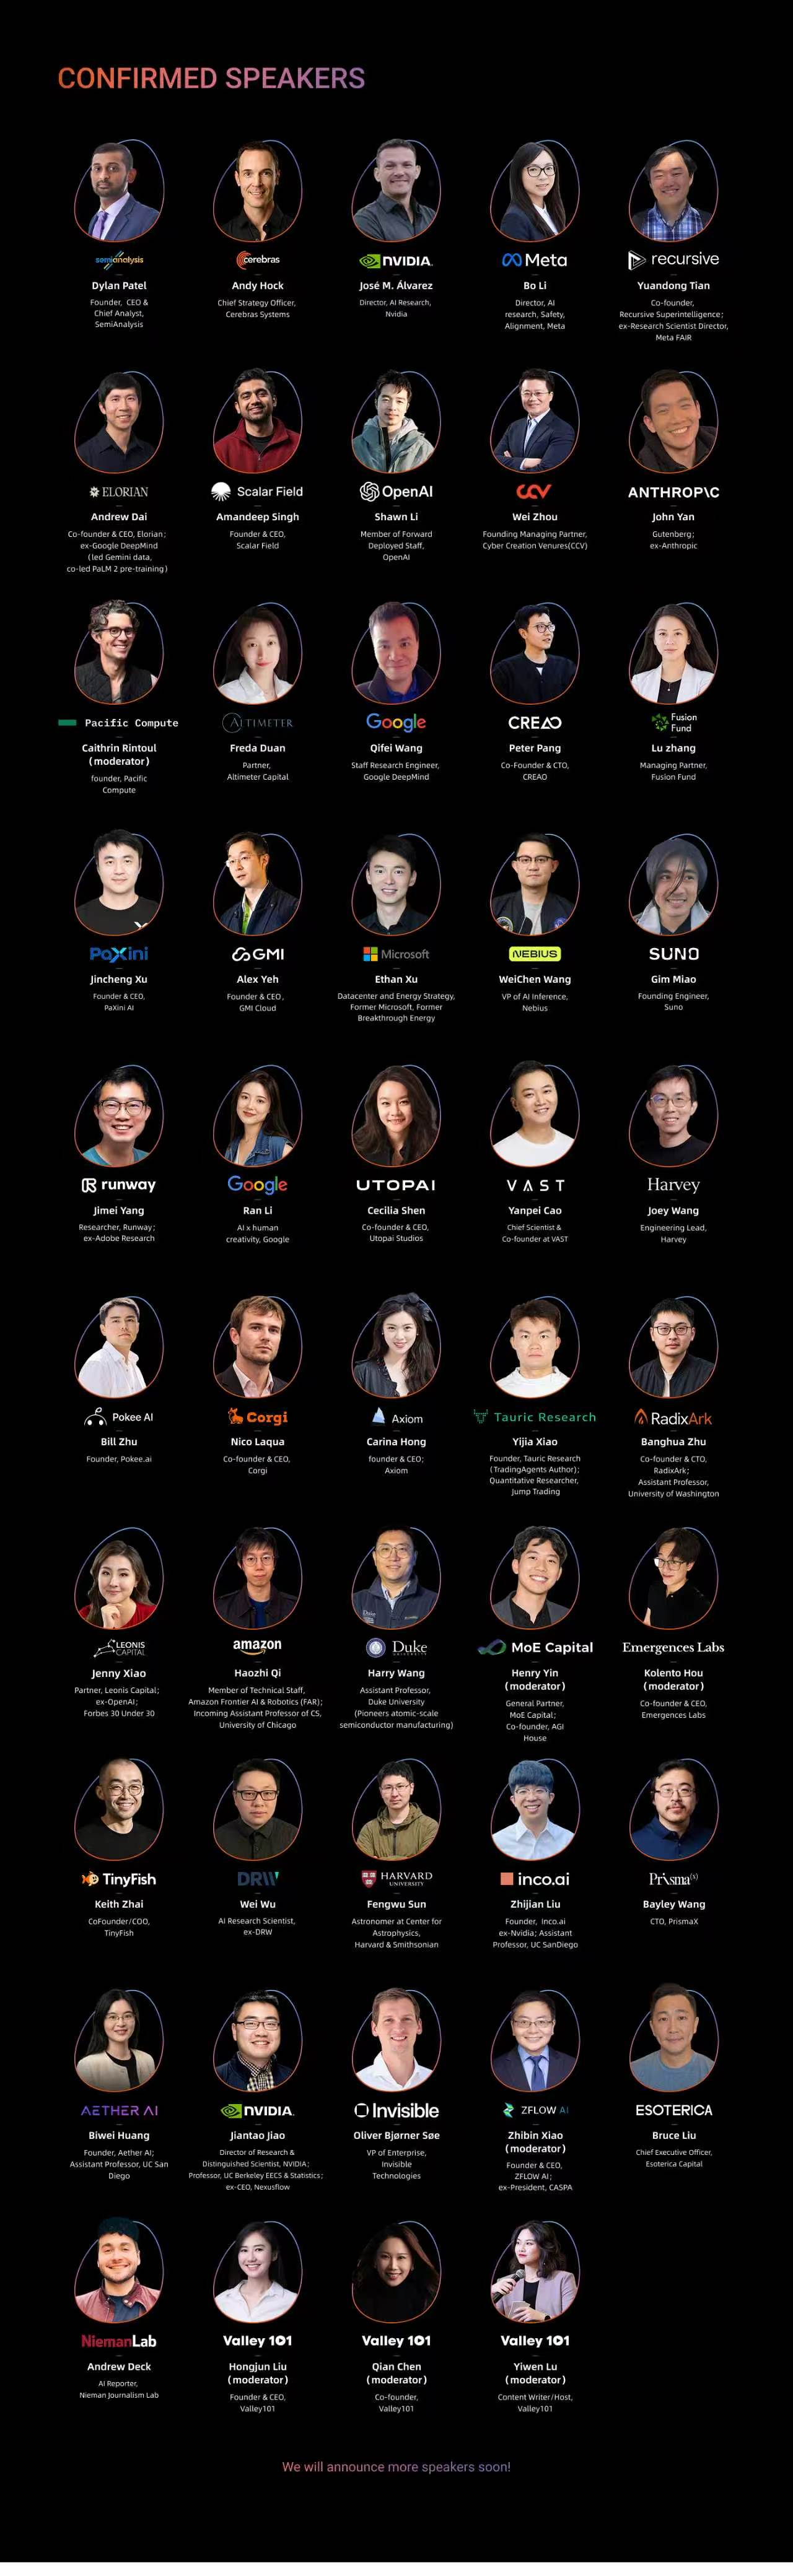
【相关阅读和名词解释】
挑战GPU、绕过HBM,深挖史上最大芯片背后的Cerebras
谷歌TPU能撼动英伟达吗?前TPU工程师首次揭秘
Prefill / Decode:大模型推理的两个阶段。Prefill(预填充)一次性并行处理完整输入提示词,生成KV缓存和第一个Token,是计算密集型,瓶颈在算力;Decode(解码)基于KV缓存逐个自回归生成后续Token,是内存带宽密集型,每生成一个词都要把整个模型权重从存储读到计算单元。
KV Cache(键值缓存):是注意力机制中的中间计算结果,避免每次生成新Token时重复计算历史Token的键值向量。当新请求与之前处理过的内容有相同前缀时,可直接复用已有KV Cache,称为“缓存命中”。
Attention / FFN:Transformer架构的两个核心模块。Attention(注意力机制)负责“找关系”,让每个Token关注序列中其他Token的信息,参数量较小但计算模式随上下文长度变化。FFN(前馈网络)负责“加工信息”,独立处理每个Token,参数量极大,是模型静态权重的主要部分。
SRAM / DRAM / HBM:SRAM用6个晶体管存1bit,延迟仅0.3-3ns,带宽性价比极高,但容量极小。DRAM用1晶体管+1电容,容量大、成本低,但延迟50-100ns且需刷新。HBM本质是3D堆叠的DRAM,通过超宽总线实现高带宽,容量较大但成本高,且市场上极度缺货。
Kernel(算子):连接AI算法与芯片硬件的“翻译官”,将矩阵乘法、注意力等算法操作转化为硬件可执行的指令。算子开发属于内核级编程,直接决定模型的推理速度、能耗和芯片兼容性。
系统级异构:指在系统层面组合不同类型的计算芯片(如GPU、SRAM推理芯片、专用加速器),用最合适的硬件做对应部分的应用,而非用一颗芯片包揽所有工作。OpenAI Jalapeño则选择将异构收进单颗芯片内部。
流片(Tape Out):指芯片设计完成后,将电路版图数据交给晶圆厂进行实际制造的过程。晶圆厂据此制作掩模(Mask),再通过光刻等工序生产芯片。流片成本极高,先进制程一次可达数百万美元,且若设计有误,整批芯片可能报废。
【监制】
泓君
【后期】
Amei
【运营】
朱婕
【BGM】
Still Waiting For You STEMS INSTRUMENTS - Wave Saver
Seven Daughters - Fabien Tell
Reclaim - Megan
【在这里找到我们】
公众号:硅谷101
收听渠道:Apple Podcast|Spotify|小宇宙|喜马拉雅|蜻蜓FM|荔枝FM|网易云音乐|QQ音乐
其他平台:YouTube|Bilibili 搜索「硅谷101播客」
联系我们:podcast@sv101.net
Special Guests: Mark and 徐子扬.